News Detail
 来源:本站
 浏览量:10000
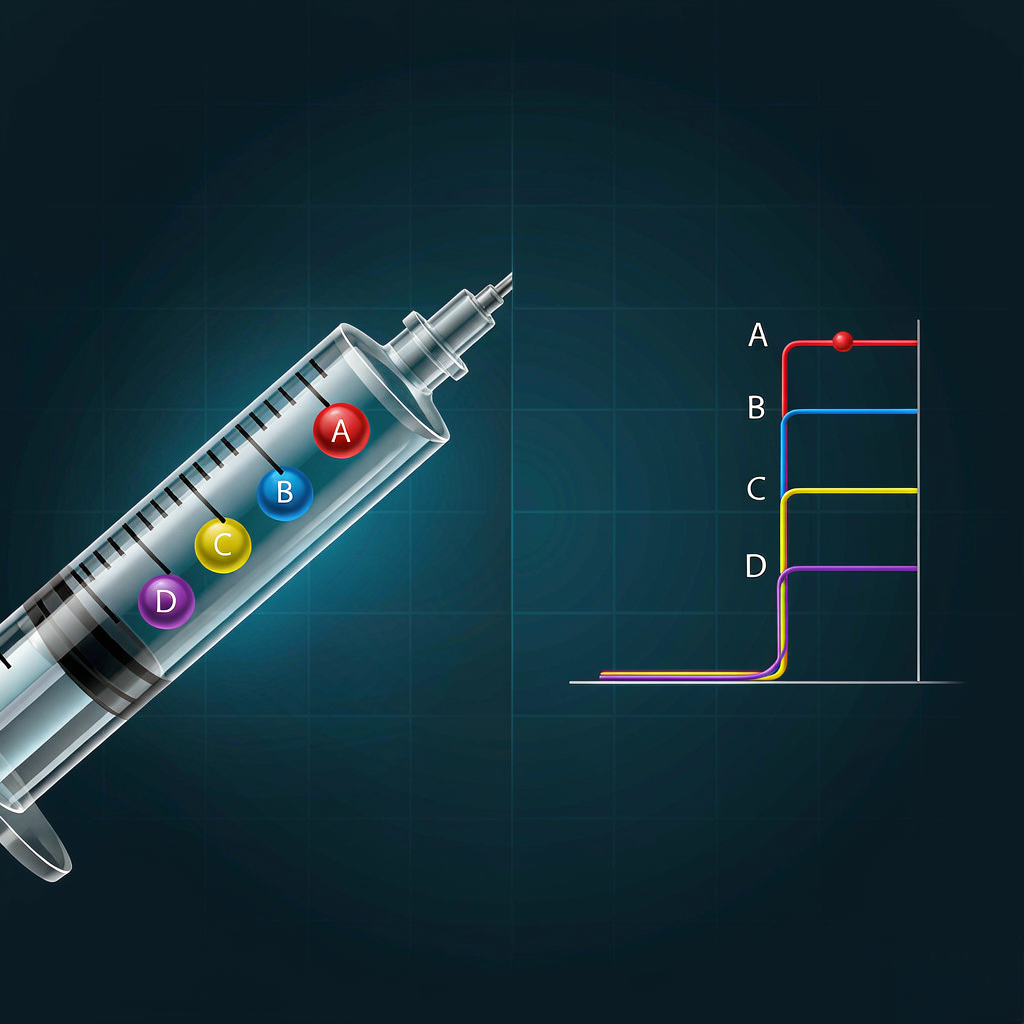
一批先导物有几十个,个个都要测 PK,如果每个都做完整采血的 Full PK,时间成本和动物用量都会爆表。有没有「更快」的测法?有,但「快」也分好几种——Cassette PK 是「几个药混在一起打一针」,Snapshot PK 是「只抽一个时间点的血」。它们到底快在哪、省在哪、又牺牲了什么,很多团队其实没想清楚就上了。
据爱思益普官网,其体内 PK 服务提供 Full PK、Rapid PK、Snapshot PK、Cassette PK 四种模型,供不同通量需求选择。
先厘清这四种模型的定位:
| PK 模型 | 核心做法 | 适合场景 |
|---|---|---|
| Full PK | 密集采血、算全套参数 | 候选物深度表征 |
| Rapid PK | 精简采血点、快速出关键参数 | 中等通量的候选物筛选 |
| Snapshot PK | 单时间点采血,快速「快照」 | 超高通量的初筛、粗筛 |
| Cassette PK | 多化合物混合一次给药 | 一批化合物的清除率横向比较 |
Cassette PK 的核心,是把多个化合物「混」在一起、经同一次给药进入动物体内,再通过分析手段分别读出每个化合物的浓度,从而「一次实验」得到多个化合物的 PK 数据。它的价值在于通量——一次给药、一套采血、一次分析,就把一批化合物的清除快慢排出来了,特别适合先导物多的早期阶段。
Snapshot PK 走的是另一条「省」的路线:不密集采血,只在关键时间点抽一次血,得到一个「血药浓度的快照」,用来快速判断「这个化合物到底吸不吸收、清得快不快」。它比 Cassette PK 更「轻」,但能提供的信息也更少,主要用于超大通量的粗筛,把明显不合格的化合物先挡掉。
两者的区别,本质是「省什么」不同:
对决策者来说,选型逻辑是「按通量和信息量找平衡」:要深度表征候选物、为申报攒数据,用 Full PK;要在一批化合物里快速排清除率,用 Cassette PK;要超大通量初筛、先挡掉明显不行的,用 Snapshot PK。核心原则是——越「快」的模型,牺牲的「信息量」越多,所以快筛模型的结果只用于「排序和淘汰」,终候选物仍需回到 Full PK 做精确表征。把 Cassette PK 的「排序结果」当成「申报数据」用,是常见的认知误区。
从适用场景看,Cassette PK 和 Snapshot PK 的价值都集中在「早期、高通量、候选物多」的阶段,它们的意义是「用更少的动物和时间,把不值得深入的化合物尽早淘汰」,从而把 Full PK 的深度资源留给少数真正有潜力的候选物。以动物用量为例,若一次要比较十几个化合物,逐个做 Full PK 需要十几组动物,而 Cassette PK 把它们混合给药,可大幅压缩动物用量与实验周期;Snapshot PK 更进一步,以牺牲信息量为代价换取的通量。官网把四种模型并列,正是为了覆盖「从粗筛到精确表征」的完整梯度,让团队按候选物数量和所处阶段,在省与准之间选到合适的档位。
问:Cassette PK 的多个化合物会互相干扰吗?
有可能。多个化合物混合给药时,若发生药物间相互作用、或分析时质谱信号互相干扰,会影响结果。所以 Cassette PK 主要用于「相对排序」,精确参数仍需 Full PK 验证。
问:Snapshot PK 和 Full PK 差在哪?
Snapshot PK 只在单个时间点采血,得到的是「一个点的浓度快照」,用于快速初筛;Full PK 密集采血,能得到完整的血药浓度-时间曲线,算出半衰期、暴露量、清除率等全套参数。前者省时省动物但信息少,后者信息全但成本高。