News Detail
 来源:本站
 浏览量:10007
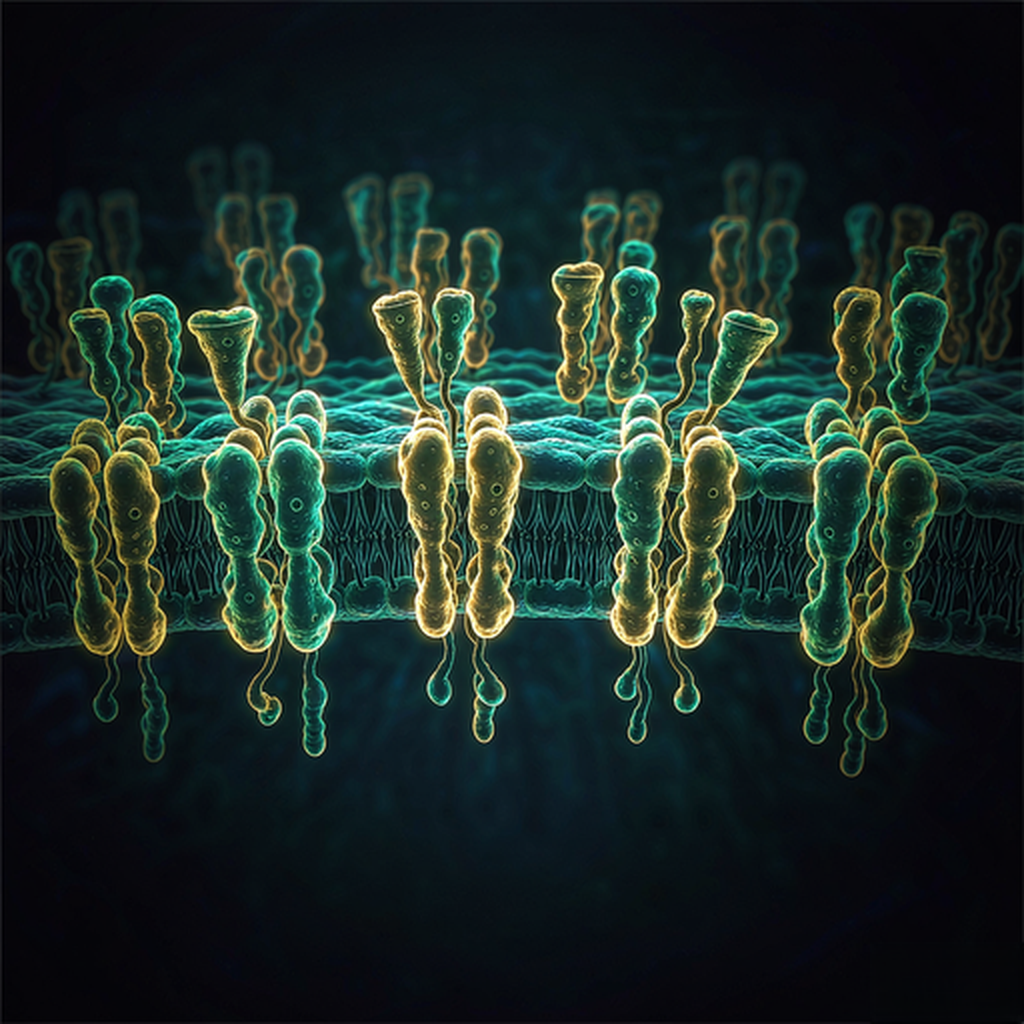
G 蛋白偶联受体(GPCR)是药物研发里绕不开的「靶点家族」——它有 800 多个成员,却长期被一种惯性支配:大多数项目只盯着阿片、多巴胺、5-HT 这几个「明星受体」,剩下的海量靶点被当成背景板。可反过来看,恰恰是那些「不明星」的受体,藏着差异化和空白适应症的机会。问题在于:你想找的靶点,平台上到底有没有、能不能测?
据爱思益普官网,其 GPCR 靶向分析服务提供 190+ 个现成可测的 GPCR 靶点,覆盖人类及临床前常用物种的变体,且靶点库仍在持续扩充。
这 190+ 个靶点不是乱铺的,而是按功能与适应症聚成几大类:
| 靶点分类 | 代表靶点(节选) |
|---|---|
| 胺能类 | 5-HT1A~7B 系列、多巴胺 D1~D5、肾上腺素 α1/α2/β、组胺 H1~H3、腺苷 A1/A2A/A2B、毒蕈碱 M1~M5、褪黑素 MT1/MT2 |
| 肽类 | 神经激肽 NK1~NK3、食欲素 OX1/OX2、血管紧张素 AT1/AT2、催产素/加压素 V1a/V1b/V2、黑色素皮质素 MC1/MC4/MC5、内皮素 ET-A/ET-B |
| 趋化因子与免疫 | CCR1~CCR9、CXCR1/CXCR2/CXCR4、FPR1/FPR2、补体 C3aR1/C5aR1、MRGPRX1/MRGPRX2 |
| 代谢及其他 | GLP-1R/GIPR/GCGR、FFAR3(GPR41)/GPR40/GPR84、S1P1~S1P3、LPA1/LPA3、生长抑素 SSTR1~SSTR5、CB1/CB2、TAAR1 |
这个布局的价值,在于「广覆盖 + 可组合」。官网明确,服务设计支持从单个靶点到定制 Panel 的灵活配置:既可以为单一靶点做深度表征,也可以把相关靶点拼成一个 Panel 做选择性或脱靶筛查;检测格式既有单剂量初筛,也有 EC50/IC50 剂量-响应确证。也就是说,同一个 190+ 靶点库,既能回答「我的分子对这个靶点活性多强」,也能回答「它会不会误伤同族的其他受体」。
再往深看,GPCR 之所以值得单独铺这么大一个靶点库,是因为它的「族内相似性」是把双刃剑。同一家族的受体(比如 5-HT 系列、CCR 系列)结构高度相近,一个分子对 5-HT2A 有活性,往往也容易对 5-HT2B、5-HT2C 有「连带」活性——而 5-HT2B 的激动与心脏瓣膜病变直接相关。这类选择性风险,只有在一个覆盖完整的家族 Panel 里才能暴露。单个靶点测得再漂亮,也回答不了「它在隔壁受体上有没有漏」。
还有一层值得单独拎出来:190+ 这个数字的分量,在于「现成可测」四个字。GPCR 家族有 800 多个成员,但并非每个都能「拿到就能测」——很多跨膜受体的表达、稳定与功能重建本身就有技术门槛。官网的 190+ 靶点,指的是已经建好、随时可用的现成靶点库,再配合结合与功能两种检测模式、单剂量初筛到剂量-响应确证的格式,等于把「找得到、测得了、测得快」这三件事一次解决。对推进中的项目来说,这比一句「理论上能做」要实在得多。
对决策者来说,判断标准很清晰:早期要验证一个「明确靶点」的活性,单靶点表征即可;一旦进入「候选物优化」或「安全性摸底」,就要把视野放大到整个家族或跨家族的 Panel,用 190+ 靶点的覆盖去排查选择性。说到底,GPCR 的成败往往不在你选的那个靶点上,而在于你没测的那些「邻居」上——一个覆盖够广的靶点库,正是为了把这个盲区补上,也让项目在「选靶、验靶、查脱靶」的每一步都有一张完整的底图。
问:190+ 靶点是指什么,是固定清单吗?
是指平台现成可测的 GPCR 靶点数量,覆盖人类与鼠、大鼠、狗、猴、兔等临床前物种变体,并且靶点库仍在持续扩充。具体覆盖可与平台确认,也可按项目需求定制 Panel。
问:只测一个靶点就够了吗?
取决于阶段。早期验证单一靶点活性,单靶点即可;但进入候选物优化或安全性评估阶段,GPCR 同族受体结构相近、容易连带脱靶,建议用家族 Panel 做选择性排查,避免漏掉「邻居受体」上的风险。