News Detail
 来源:本站
 浏览量:10009
新药发现有一个根深蒂固的惯性:先锁定一个靶点,再围绕它去筛分子。这套"靶点驱动"的路径逻辑清晰、便于机制解释,也确实是当代药物研发的主流。但它有个盲区——它假设我们已经知道"该打哪个靶点"。而真实的疾病远比我们想象的复杂,很多疑难病症的分子机制至今没被完全破解,靶点究竟是谁、甚至是否存在一个"单一可打"的靶点,都是未知数。这时候,另一条更古老的路径反而能派上用场:表型筛选(phenotypic screening)。
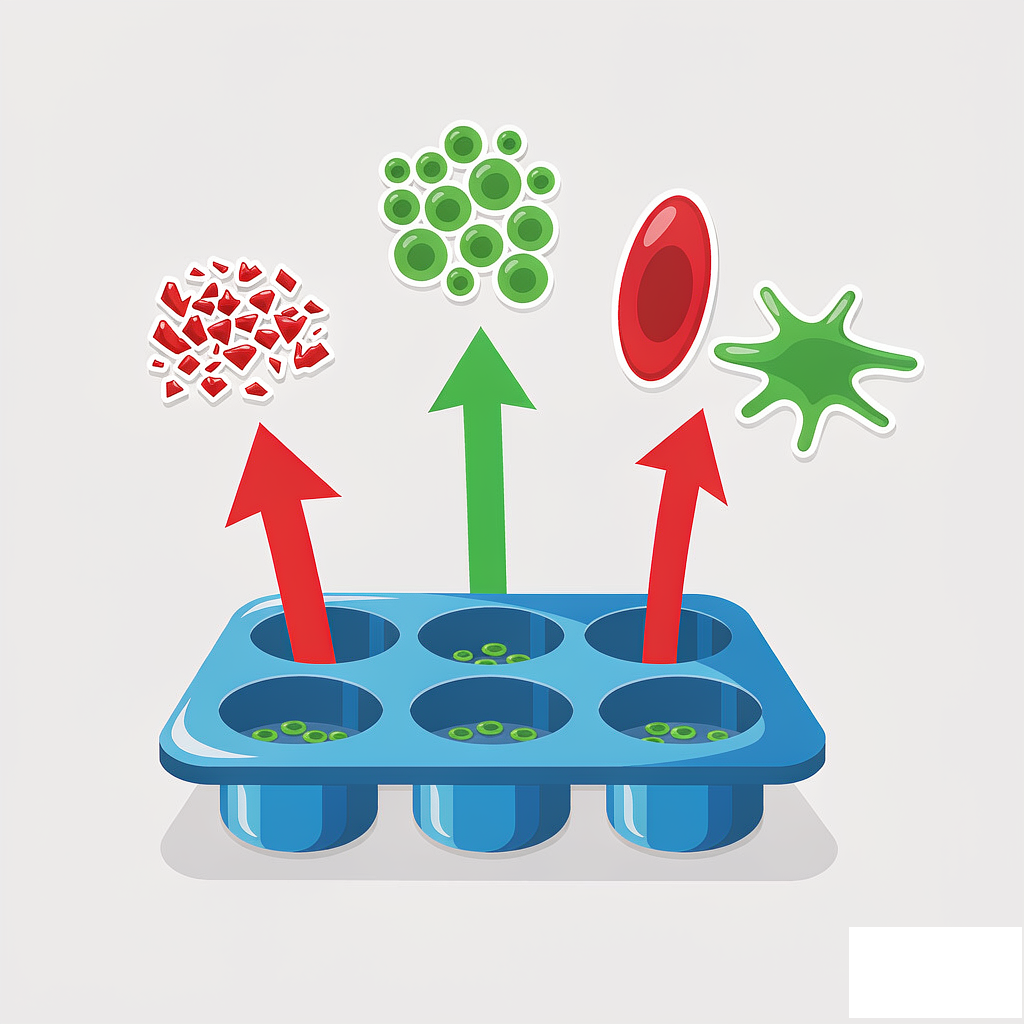
表型筛选的思路,是"绕开靶点,直接看结果"。它不预设分子要结合哪个蛋白,而是把候选化合物投到一个能模拟疾病特征的细胞或生物模型上,直接观察"表型"有没有朝我们希望的方向改变——肿瘤细胞有没有停止增殖或走向凋亡、纤维化有没有逆转、炎症因子有没有下降。换句话说,它问的不是"分子打中了谁",而是"分子有没有把病治好一点"。只要表型改善了,就说明这个分子值得继续深挖,至于它到底通过什么靶点起效,可以留到下一步再去"反向破译"。
这套"从表型出发"的方法,有着靶点筛选难以替代的价值。其一,它不依赖对靶点的先验知识,天然适合那些机制不明的疾病。其二,表型筛选测的是"系统层面的净效果",一个分子即使同时微弱作用于多个靶点、通过协同才起效,也能被表型读数捕捉到——这种"多靶点、弱作用、强协同"的分子,恰恰是纯靶点筛选容易漏掉的。其三,表型模型往往更贴近真实的生理病理环境,筛出的分子"翻译成功率"有时反而更高。事实上,回顾历史,相当一部分 first-in-class 药物初正是从表型筛选里"撞"出来的,而非精挑细选的靶点。
当然,表型筛选也有它的代价。的难题是"命中之后怎么办"——你筛到了一个让肿瘤细胞凋亡的分子,却不知道它打的是谁。这就需要后续的靶点去卷积(target deconvolution)工作:通过化学蛋白质组学、亲和富集质谱、遗传学手段等,去反向找出分子真正的作用靶点。此外,表型筛选的假阳性、脱靶风险也需要更谨慎地把控,因为"看起来有效"的分子,可能藏着一个安全性上不可接受的机制。所以,成熟的表型筛选从来不是"撞大运",而是"高通量表型读出 + 严谨靶点解析"的组合拳。
爱思益普在表型筛选的"读出"环节积累了扎实的能力。平台的癌细胞 panel 筛选覆盖数百种人源肿瘤细胞系,可在 2D 增殖、3D 增殖、克隆形成、凋亡等多个维度上批量读表型,配合高内涵筛选(HCS)一次实验同时捕捉细胞的形态、增殖、凋亡、蛋白定位等多种"表情",把表型变化从"肉眼看"变成"高通量、多参数、可量化"的数据。对希望跳出"唯靶点论"、在难成药领域或机制不明疾病里另辟蹊径的团队来说,这套表型读出能力,是"从表型出发找药"这条路能否走通的块基石。