News Detail
 来源:本站
 浏览量:10002
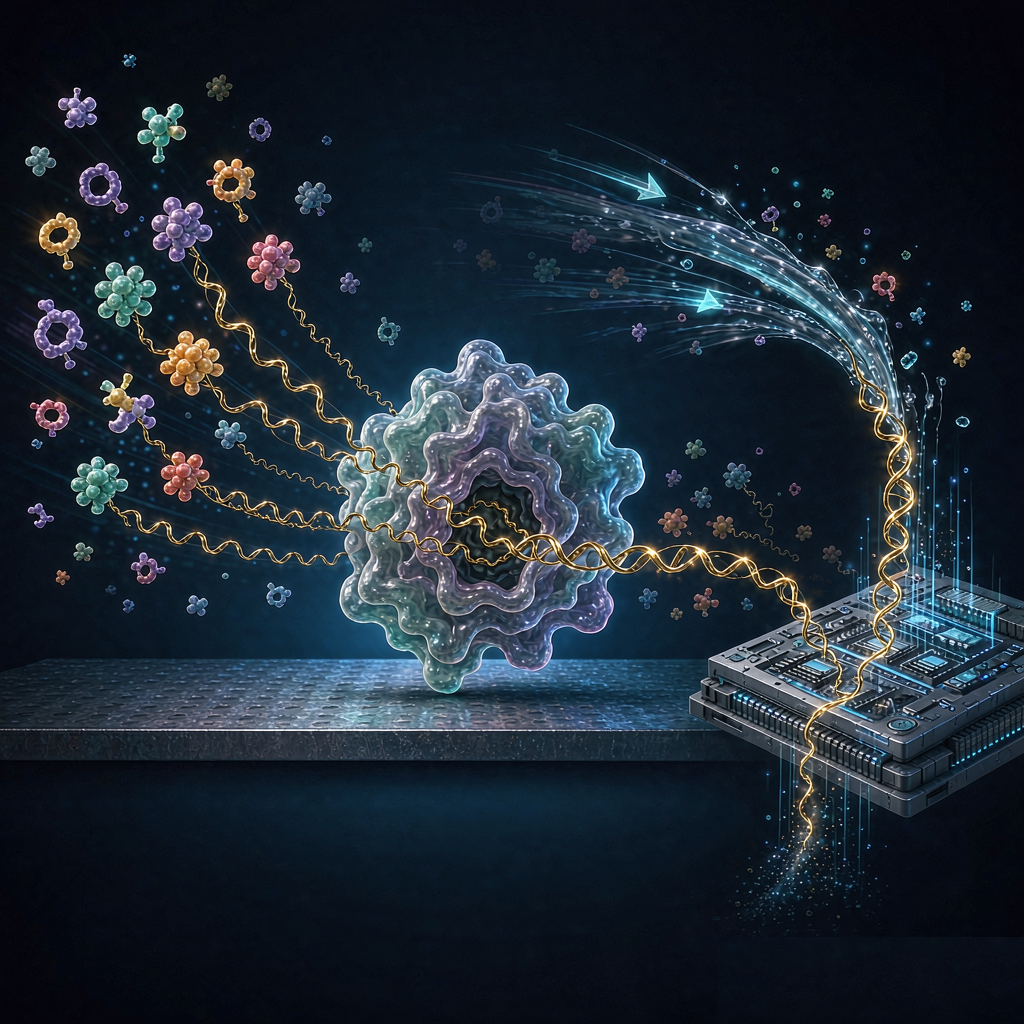
DNA 编码化合物库(DNA Encoded Library,简称 DEL)是近二十年来小分子药物发现领域变革性的技术之一。它的核心思想朴素而巧妙:给库里的每一个化合物分子都连上一段独一无二的 DNA 序列,作为它的"身份证"或"条形码"。凭借这个条形码,一次实验就能在数以亿计、甚至万亿计的分子中,找出那些能与靶蛋白结合的"苗头化合物"。
DEL 库的构建依靠一种叫"split-and-pool"(分配-混合)的组合化学策略。简单来说,就是把一批分子骨架分成多份,每一份分别连上一个化学基团,同时用一段特定 DNA 序列记录下"这一步连了什么"。然后把所有份重新混合、再分成多份,进行下一轮反应并再次用 DNA 编码。如此循环若干轮,库的规模以指数级增长——三轮组合就能达到数百万,五轮以上就能达到数亿到万亿级。终,每个分子的"化学结构"与它的"DNA 编码"一一对应,DNA 序列成了可以读回结构的钥匙。
DEL 筛选的流程堪称"高通量"的。研究者把目标蛋白(通常是纯化的靶点蛋白)固定在固相载体上,让整个 DEL 库与之一起孵育。能与靶蛋白结合的分子会被"捕获"下来,不结合的则被洗脱除去。经过多轮洗涤富集后,把捕获下来的分子上的 DNA 编码进行 PCR 扩增和高通量测序,就能读出"哪些分子被富集了",再通过编码反推出它们的化学结构。整个过程一次孵育就能筛查整个库,成本远低于传统的高通量筛选(HTS)。
DEL 技术的价值,在于它对"难成药靶点"的突破能力。传统 HTS 依赖现成的、类药性良好的化合物库,而 DEL 库的分子多样性和化学空间覆盖远超传统库。对于缺乏明确结合口袋、没有已知配体的靶点,DEL 常常能"无中生有"地找到全新的结合起点,为后续的药物设计提供宝贵线索。此外,DEL 还能用于发现变构位点结合剂、蛋白-蛋白互作抑制剂等传统方法难以触及的分子。
DEL 也并非万能。其一,DNA 的存在限制了可用的化学反应类型,必须在"DNA 兼容"的温和条件下合成,这在一定程度上约束了库的化学多样性。其二,DEL 筛选出的分子往往分子量偏大、类药性欠佳,需要后续的片段优化和成药性改造。其三,DEL 读出的是"亲和力富集信号",需要结合其他生物物理方法(如质谱分子互作、表面等离子共振等)做二次确认。因此,DEL 通常与片段筛选(FBDD)、HTS 等方法互补,共同构成现代苗头化合物发现的工具箱。
对药企而言,DEL 代表了一种"以规模换概率"的筛选哲学——用海量分子对抗靶点的难成药性。它正在成为靶点筛选和苗头化合物发现环节越来越重要的标准配置。
从实际操作的角度看,DEL 筛选的价值链还延伸到后续的确认与优化环节。筛选中富集出的"命中"分子,其结合信号需要借助表面等离子共振(SPR)、质谱分子互作等正交方法进行复核,确认其结合是否特异、亲和力处于什么量级;确认后的先导分子,则进入结构优化和成药性改造阶段。也就是说,DEL 解决的往往是"从无到有"的公里,它撬动的难成药靶点越难,后续确认与优化环节的配合就越关键。这也是为什么一个成熟的靶点筛选平台,通常会把 DEL、生物物理互作检测和细胞功能验证整合成一条连贯的发现链路。